摘要:它不生成一个字,只返回校准过的概率,单次判断约万分之一元。我让它给大模型当门卫、评审员、质检员,把 Agent 的决策成本打了两个数量级——数字全部实测。

先认识主角:Jev,TypeSafe 九月发布的模型,走了一条没人挤的反路——一个字都不写。它没有聊天窗口、不逐字生成:你给它一个状态,加几道预先定义好的判断题,它直接返回每个选项的概率和自己的把握。心理学里这叫”系统一”(快速直觉的判断),ChatGPT、Claude 那些逐字思考的是”系统二”——Jev 只做系统一,给它一个状态,它回答你预先定义好的判断题,并告诉你有多大把握。
一个真实浏览器 agent 的任务:打开 GitHub Trending,从页面上的 1227 个链接里找到热门第一的仓库,再钻进它的 Issues 页。它完成了:4 次决策,约 20 秒,总花费约两厘钱(0.002 元,本文金额按 1 美元 ≈ 7 元折算)。

操盘这四步的,就是刚才这位”不会写字”的判断模型。
一、三种题型,就是它的全部语法
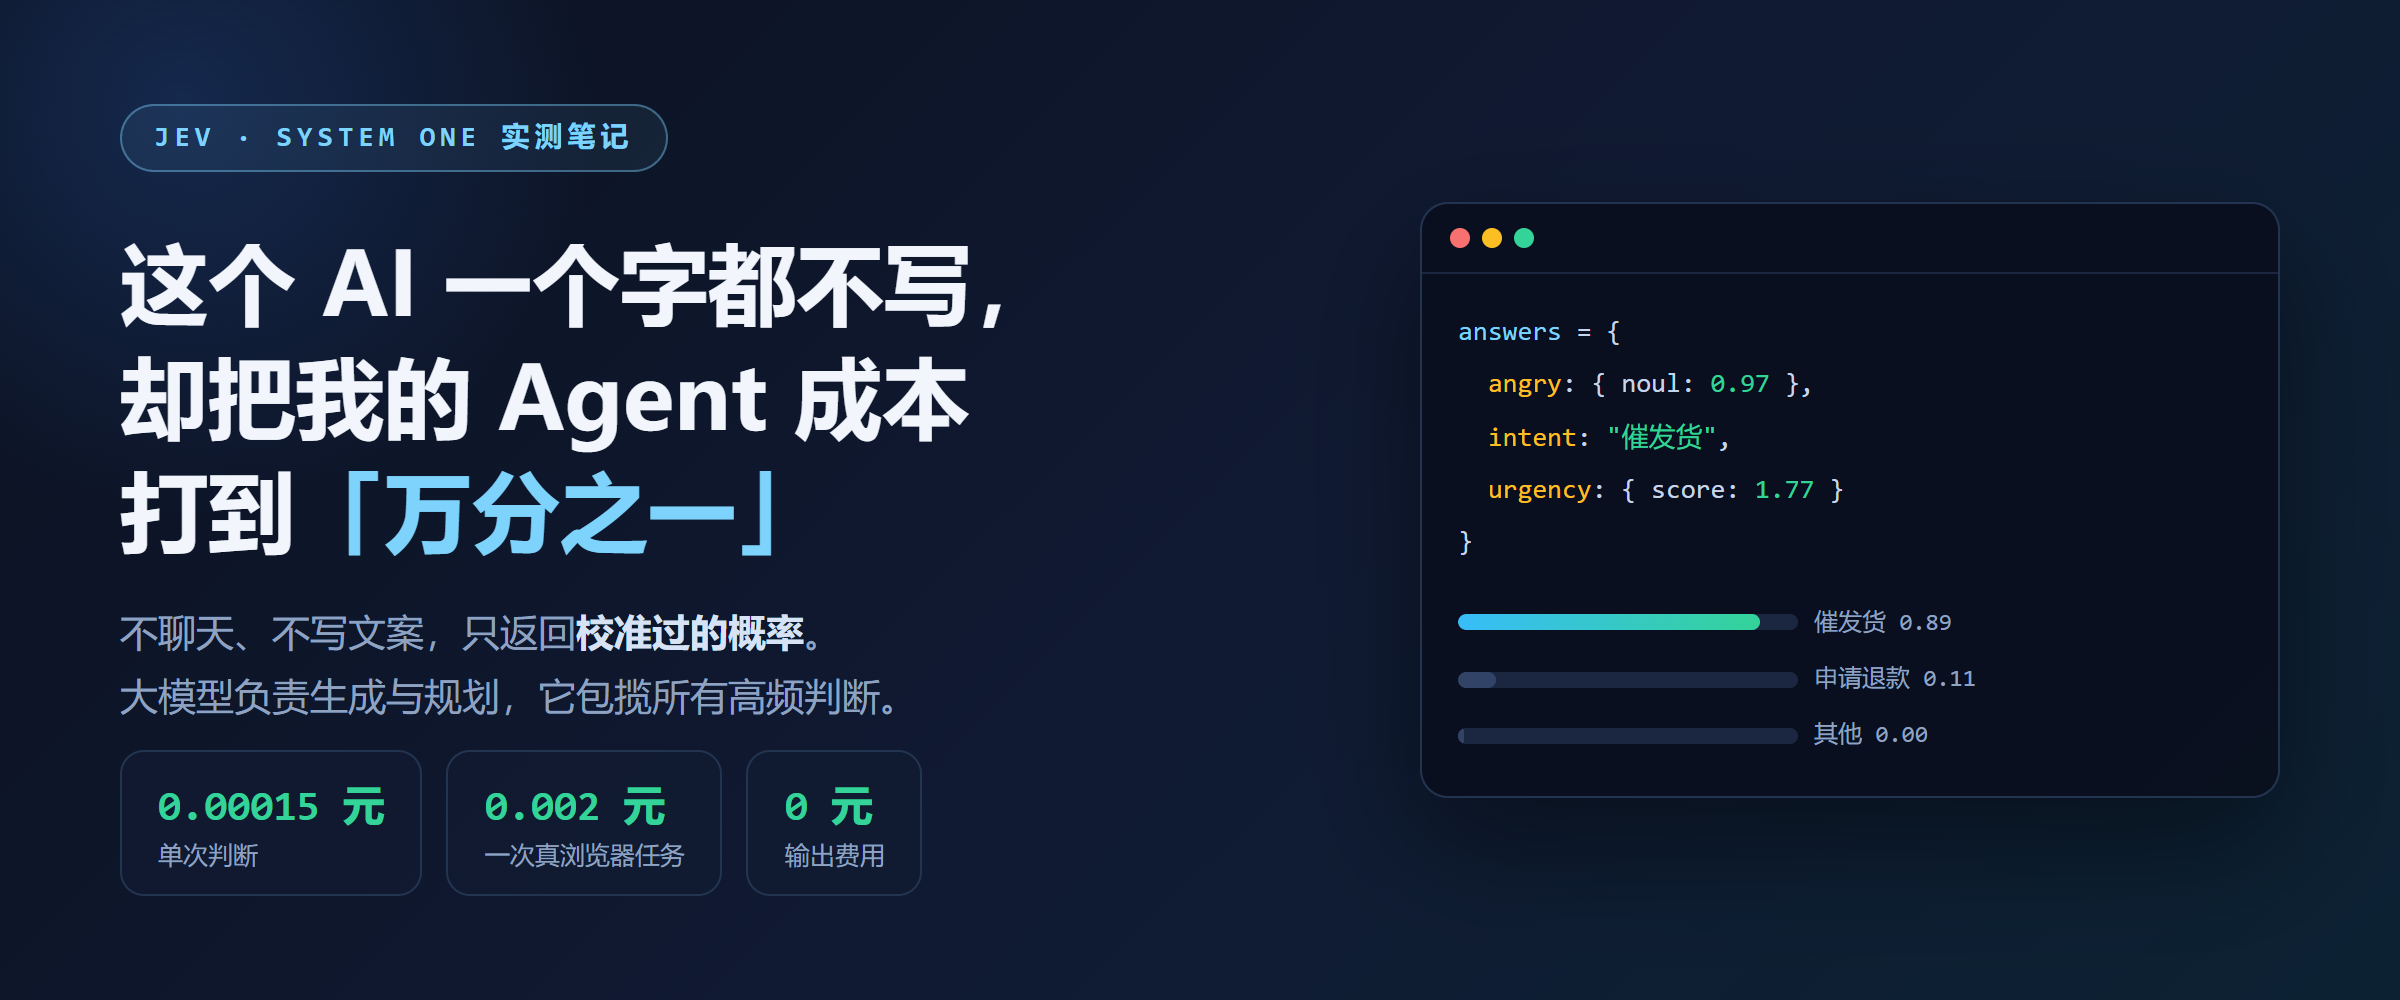
它没有聊天接口,问题只有三种题型:是非题(”用户在生气吗?”→ 返回 0.97 的概率)、选择题(从你给的选项里选一个,附带完整概率分布和置信度)、评分题(在量尺上打连续分,返回 1.77 意思是”介于中和高之间、明显偏 high”)。

妙处在概率是校准过的:0.9 以上自动处理、模糊地带转人工,阈值由你定;而且不可能幻觉——它只能从你给的选项里选,编不了别的内容。和聊天模型比,差异是结构性的:没有思维链、不解释推理,只给结论和把握;换来的是输出免费、永远不会输出非法 JSON。一句话定位:Jev 是应用里的”判断零件”,不是”写作零件”——写文案、翻译、总结都轮不到它,但”该不该、像不像、选哪个”这种题,它又快又便宜:输入约 0.3 元/百万 token,输出免费,单次请求约 0.00015 元。同样的事让 GPT-4o 级模型做分类再解析 JSON,通常贵 1–2 个数量级。
二、让大模型只干贵活
分工一句话:生成与规划交给大模型(少而贵),高频判断交给 Jev(多而便宜)。

四种玩法我都实测过。门卫:客服消息先过 Jev 四问并行,约八成简单判断直接模板直答,大模型一次都不用调;愤怒概率 > 0.85 且紧急度 > 1.5 的,同时亮”人工优先”灯。评审:大模型写 4 条候选文案,Jev 一次请求并行打分选优,约 0.0002 元,比让大模型自评低两个数量级。教练+执行:大模型看一眼迷宫写下 60 字策略,Jev 每步选方向,10 步通关——恰好是理论最短路径,全程约 0.0016 元。
而且 Jev 的判断结果(意图、情绪、紧急度)会作为上下文喂给大模型——专家上场前,病历已经递到手里了。
最贴近日常的是质检:大模型写文案,Jev 三关验收(吸引力、切题、用词安全),哪关不过就把评委意见原样拼进重写提示词。实测第一稿被打回 → 带意见重写 → 第二稿过审,两次质检共约 0.0003 元。字数这种事由应用代码直接数,不劳烦 AI;三稿都不过,就按吸引力分推荐最好的一稿兜底。

这里有个值钱的教训:过关线定 2.0 分能稳定过审,定 2.2 则几乎永远过不了——阈值必须拿自己的真实样本校准,别人的数抄不得。
三、1227 个链接,先砍到 25 个
agent 循环只有四步:观察 → 提问 → 决策 → 执行。Jev 是大脑,动手的全是你的代码,而它的智商上限取决于一件事:你喂给它的选项质量。1227 个链接,我本地先剪成 25 个编号候选再交给它。四个坑都是真踩过的:
- 排序要用精确匹配——前缀匹配让
?lang=xx这类变体挤掉了真仓库; - 不可见链接要过滤——DOM 里存在但点不动,agent 选了就卡死;
- 同页链接要剔除——对 agent 是无操作,纯浪费步数;
- 动作空间要覆盖子路径——你剪掉的动作,模型永远选不到:Issues 页是三段路径
/owner/repo/issues,我的正则只认两段时,它根本进不了候选,Jev 只能在页脚的营销链接里挑。
迷宫里还有个变种:低置信度时 Jev 在两格间来回打转。修法不是改提示词,是把”原路返回”从选项里直接删掉。给 Jev 的选项集,本身就是最强的提示词。顺手一个增益:把本地几毫秒就能算好的特征(目标方位、近期走位)写进 state,别指望模型自己从图里推——配合教练策略,命中后的步骤置信度经常直接顶满 1.0。能便宜算的,就别花模型的钱。
四、拿到概率,别只会取最大值
Jev 返回的是校准过的概率和置信度,无脑取最大值等于把弹性工资签成了死月薪。三种我实际在用的分支:
// ① 双阈值:高置信自动处理,模糊地带升级人工
p > 0.9 ? autoQueue() : p > 0.5 ? humanReview() : normalQueue();
// ② 低置信兜底:分布太散,说明问题本身模糊
confidence > 0.7 ? routeTo(choice) : routeTo(fallback);
// ③ 连续分:1.77 这种"偏 high"的信息,取整拿不到
if (urgency.score > 1.5) bumpPriority();
①就是经典的”廉价第一道过滤”:Jev 拦下八成简单判断,只有低置信度或复杂请求才进大模型。两个数量级的成本差,主要就是这么省出来的。
顺带一个调试心得:把每一步的概率条、置信度、耗时、费用实时画在页面上,做 agent 的体验会完全不同。概率是 Jev 的一切——看它”犹豫”(分布平)往往比看它”选了什么”信息量大得多。
真要上线,还有四关要过:校准验证(拿 20–50 条真实样本对照人工标注,概率质量取决于你的题目写法,不是模型给的数就能直接抄);锁版本(用 ~typesafe/jev-1.13 而非 -latest,别让模型静默更新把阈值作废);超时与降级(alpha 端点随时可能变更,失败要能回退到关键词规则或小模型,别让决策层单点故障);概率落日志(答案和费用一起记下来,回溯校准和成本核算全靠它)。
至于 API 层那些文档没写的坑(slug 必须带 ~ 前缀、questions 是 record 不是数组、字段叫 instructions/criteria 而非 question/options、score 返回连续值而非档位、OpenRouter 公开模型列表里根本查不到它……),全部经过报错信息逐一验证,整理在开源仓库的 readme 里,照抄能省你一晚上。
五、一分钱能干什么

上面所有数字都是真实账单:每个示例都在打印单步耗时和费用,”实测记录”。
什么时候该用它?选项有限、调用高频、需要概率——判断的归 Jev。什么时候不该?要写文案、要开放式规划——生成的归大模型。最好用的形态从来不是二选一,而是双系统:大模型定策略、写文案、兜底复杂请求,Jev 在每一次”该不该、像不像、选哪个”的关口上,便宜地站岗。
文章摘自:https://www.cnblogs.com/softlin/p/23185975
 京ICP备14020293号-4