Agentic Search 的核心原理
Agentic Search(也称 Agentic RAG)把「检索」从一次性、固定参数的动作,升级成由 LLM 自主决策、可迭代、可反思的工具调用过程。它不再是「问题 → 固定 Top-K 检索 → 生成」,而是「问题 → 思考 → 决定是否检索/怎么检索 → 观察结果 → 再思考 → …… → 最终回答」。
1. 核心思想:检索变成「可规划的工具」
传统 RAG:
Query → Retriever(Top-K) → Context → LLM → Answer
检索参数(K、查询语句、过滤条件)是写死的,LLM 只能被动使用结果。
Agentic Search:
Query → LLM(规划) → 调用检索工具(可多次、可改写) → 观察结果 → 反思/再规划 → …… → 最终生成
LLM 拥有「检索工具」的使用权,自己决定:
• 要不要检索
• 用什么查询语句
• 检索几次
• 当前证据够不够
• 要不要改写查询或拆分子问题


这本质上是 ReAct(Reason + Act) 范式在检索场景的落地:先推理(Reason),再行动(Act = 调用检索),再观察(Observation),循环直到满足停止条件。
2. 关键机制(原理拆解)
|
机制 |
作用 |
解决什么问题 |
|
查询规划 / 分解 |
把复杂问题拆成多个子查询 |
答案分散在多处时,单次查询覆盖不全 |
|
工具调用(Tool Calling) |
把检索器封装成 tool,LLM 主动调用 |
从「被动接收」变成「主动获取」 |
|
反思 / 评分(Reflection / Grading) |
对检索到的文档或中间答案打分:相关?充分?有幻觉? |
过滤噪声、判断是否需要再检索 |
|
查询改写(Query Rewriting) |
根据已有结果优化下一轮查询 |
提升后续召回质量 |
|
停止条件 |
最大轮数、置信度阈值、token 预算、信息充分性判断 |
防止无限循环、控制成本 |
|
状态管理 |
记录已检索片段、子问题、中间结论 |
避免重复检索、支持多跳推理 |
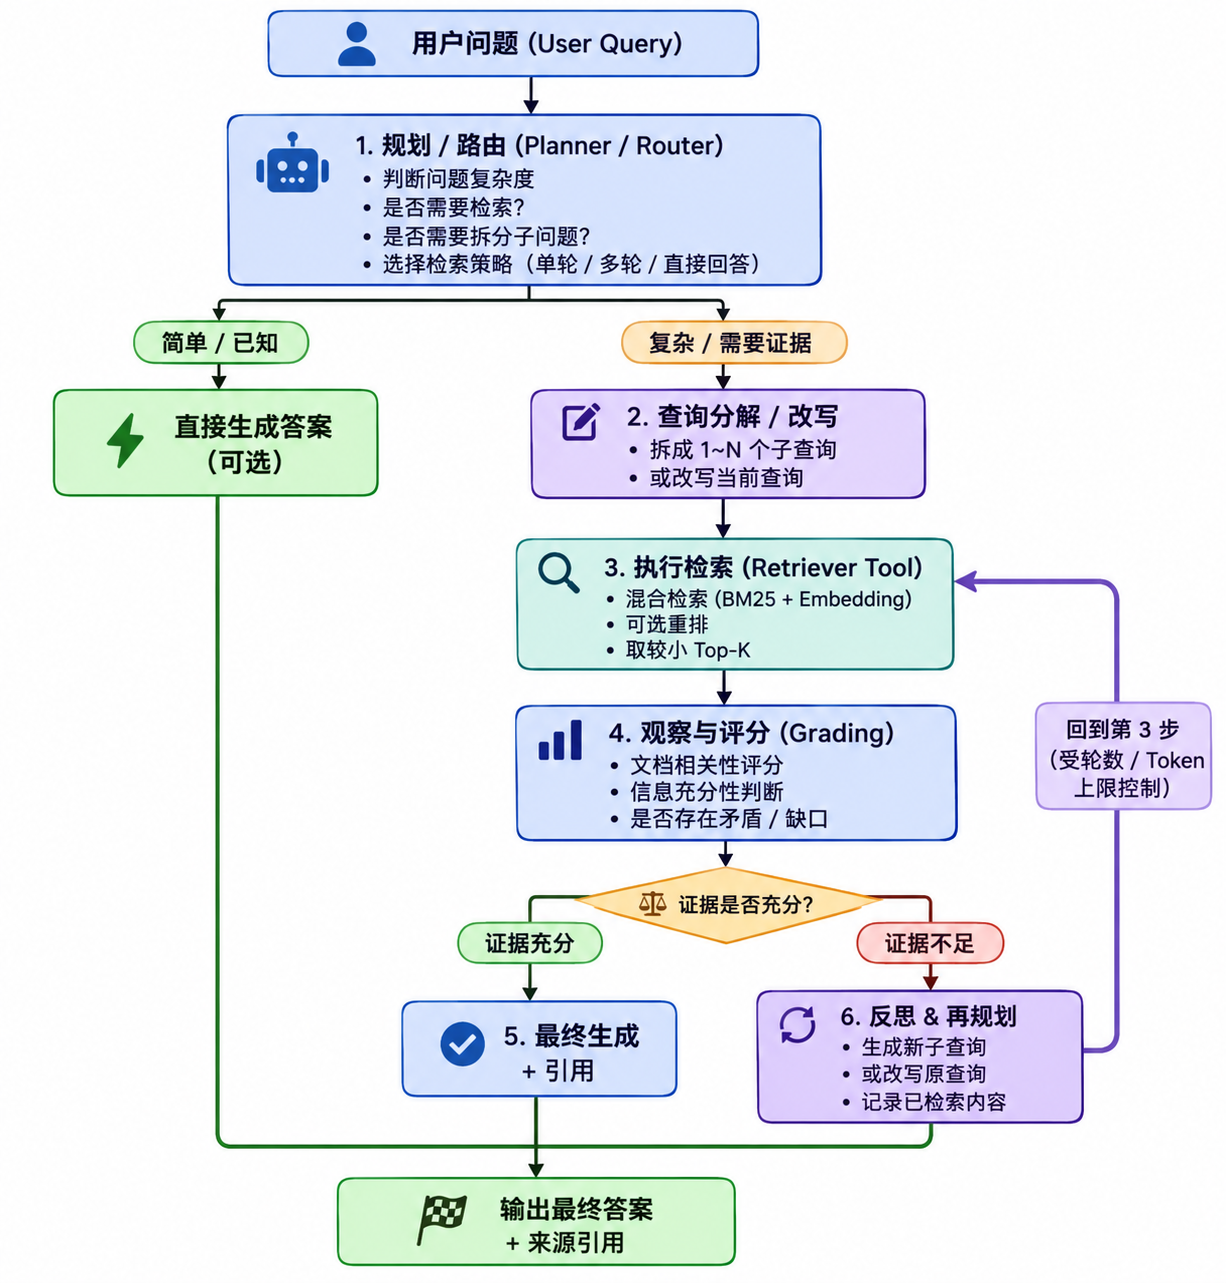
3. 典型工作流(简化版)
接收问题
规划:LLM 分析问题复杂度,决定策略(直接回答 / 单次检索 / 多轮拆解)
执行检索:调用混合检索(或向量/关键词),拿到候选片段
观察与评分:判断这些片段是否相关、是否足够回答问题
决策
生成 + 可选二次验证:基于收集到的证据生成答案,有时再做一次 groundedness 检查
— 足够 → 进入最终生成
— 不够 → 改写查询 / 提出新子问题 → 回到第 3 步
这就是为什么它能解决「Top-K 太小漏信息、太大塞爆上下文」的矛盾——每次只取少量高相关内容,通过多轮按需补全,而不是一次性塞大量文档。
4. 与传统 RAG 的本质区别
• 决策权:从工程师预设 → LLM 运行时决策
• 检索次数:固定 1 次 → 动态 0~N 次
• 查询质量:原始问题直接检索 → 可改写、可分解、可迭代优化
• 上下文控制:固定窗口 → 按需精选最小充分集
• 适用场景:简单事实问答 → 多跳、证据分散、低覆盖知识库
5. 原理背后的关键假设
LLM 具备一定的「元认知」能力:能判断自己知道什么、还缺什么。
检索工具是可靠的(因此底层仍推荐混合检索 + 重排,保证单轮质量)。
通过反思和停止条件,可以把额外成本控制在可接受范围内。
「短路径优先」:简单问题尽量走单轮,复杂问题才启动多轮,兼顾效果与成本。
RAGflow项目中Agentic Search
Agentic Search 主要实现在 internal/agent/tool/agentic_search.go 的 AgenticSearchTool,它在 internal/agent/tool/registry.go 中注册为 hybrid_search、vector_search、bm25_search 三个工具。另外,聊天侧的 Agentic 检索(ReAct 循环)实现在 internal/agentic_rag 包和 internal/service/agentic_pipeline.go 中,两者是相关但不同的系统。
1. Canvas 工具:AgenticSearchTool
核心实现在 internal/agent/tool/agentic_search.go:
- 三种检索模式由常量定义:hybrid_search(权重 0.3)、vector_search(1.0)、bm25_search(0.0) agentic_search.go:36-40
- AgenticSearchTool 结构体持有 mode 和 weight,NewAgenticSearchTool 按模式设置向量相似度权重 agentic_search.go:65-81
- InvokableRun 解析参数后调用 GetRetrievalService().Search(),强制 AllowDenseFallback=false 和 ExcludeCompiled=true,并通过 canvasDatasetIDs 做 KB 权限交集 agentic_search.go:102-146
- narrowByKeywords 对结果做关键词句子级裁剪(移植自 Python 的 _narrow_by_keywords) agentic_search.go:151-172


注册与上游调用
- 三个模式在工具注册表中映射到 NewAgenticSearchTool 工厂 registry.go:43-45
- 底层检索走 NLPRetrievalAdapter.Search(internal/agent/tool/retrieval_nlp.go),处理元数据过滤、跨语言翻译等 retrieval_nlp.go:253-277
- 行为由测试固定:禁用 dense fallback、排除 compiled 结果、透传检索错误 retrieval_test.go:125-144 retrieval_test.go:168-187
2. Chat 侧 Agentic 检索(相关但独立的系统)
在 internal/service 和 internal/agentic_rag 中,是另一套面向对话的 Agentic RAG:
- AsyncChat 在 kwargs[“agent_mode”] 或 reasoning level 为 agentic 且有 KB 时,分发到 s.agenticRag(…) chat_pipeline.go:288-297
- agenticRag 驱动一轮 ReAct 循环:设置 15 分钟超时、50 万 token 预算、证据注册表 EvidenceRegistry agentic_pipeline.go:76-135
- 默认模板 smart-reasoning 在 conf/agentic_rag.yaml 中定义,工具集为 grep_chunks、search_bm25_chunks、search_semantic_chunks、list_chunks 等 agentic_rag.yaml:1-18
- 图谱工具如 graph_explore 在 internal/agentic_rag/tool_graph_explore.go 中实现 tool_graph_explore.go:33-40

Notes
- 注意命名区分:agentic_search.go 里的工具名是 hybrid_search/vector_search/bm25_search(Canvas Agent 节点用);而 chat pipeline 的 agentic 模式用的是 search_bm25_chunks/search_semantic_chunks/grep_chunks(internal/agentic_rag 包),两套工具名不同、实现也不同。
- 文档侧入口:docs/guides/chat/chat_configuration.md 的 “Agentic Settings” 描述了用户如何配置该模式 chat_configuration.md:109-119
一句话总结
Agentic Search 的原理 = 把检索变成 LLM 可自主调用、可迭代优化的工具,通过「规划 → 行动 → 观察 → 反思」的闭环,动态补全分散证据,从而在不盲目扩大 Top-K 的前提下提高覆盖率与答案质量。
它不是新的检索算法,而是检索的编排与决策范式。底层检索器可以是 BM25、向量、混合、图谱,甚至文件系统搜索;真正的差异在于「谁在决定什么时候查、怎么查、查到什么程度停」。
文章摘自:https://www.cnblogs.com/wintersun/p/23604871
 京ICP备14020293号-4